拍摄日课 · 01
先拍一场能检查的戏,再谈完整短剧
AI 短片最容易死在「我想一次拍完一整集」。一整集意味着多镜头、多次走位、同一张脸、同一套服装,声音还要接得上。当前视频模型给不了你脑子里的长片,它能稳定交付的是一场 4–15 秒、事后可以逐帧检查的短戏。检查得了,才叫成片。
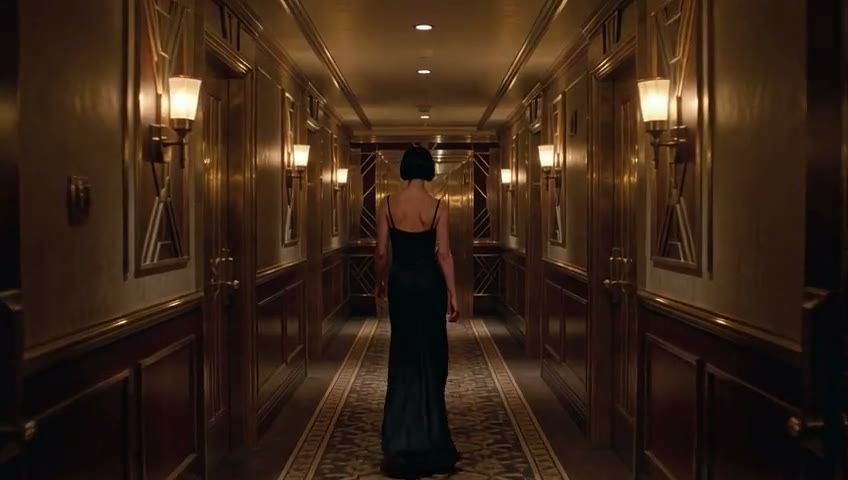
日课怎么用
这不是工具榜,也不是提示词合集。黄果制片的拍摄日课每次只留一个今晚就能进片场的制作思路。中文、英文、日文写的是同一课,不是三篇互相翻译的空壳。
规则很硬:不把一次成功说成稳定能力,不拿别的产品的成片冒充本站结果。角色默认使用原创虚构角色或你拥有合法授权的素材,禁止任何未成年相关描写与未授权真人形象合成。
今天的核心:能检查,才叫成片
「很有故事感」「很有电影感」不是验收标准。你无法据此决定下一镜该改提示、换首帧,还是改走角色参考。能检查的戏,验收项在生成前就写在纸上。
先把一部片收成一场戏:一个房间,一种主光,一个主要动作,一种运镜,一段时间(建议 6–8 秒)。拍完打开成片,逐帧看,而不是只看封面循环。
- 角色面部骨相有没有在 6 秒里漂成另一个人
- 核心戏剧动作有没有真正发生,还是被折成模糊的站桩空镜
- 衣服、房间、光线有没有中途换了一套
- 镜头运动是不是你写的那一种,有没有自己加切镜或字幕
- 声音是呼吸和环境底噪,还是莫名其妙的配乐
五栏提示,而不是一段小说
把提示写成五栏。缺一栏就补,不要用形容词堆出「电影感」。人物对手戏要写到具体动词:谁转向谁、手停在哪、目光落在哪。模型需要可执行的空间动作,而不是「宿命感」「拉扯感」这类抽象词。
身份栏必须写清人数、虚构角色设定、发型与服装。地点栏只保留一个空间和一种主光。动作栏只安排一个主要节拍。镜头栏只选一种运动。声音栏写现场声,并明确不要配乐、不要字幕。
- 身份:虚构角色设定;发型、服装、体态、人数
- 地点:一个房间,一种主光(例如暖色套房 + 黄昏窗光)
- 动作:一个主要戏剧动作,写到具体肢体与眼神方向
- 镜头:推、摇、固定或后拉,只选一种;不要又推又切
- 声音:呼吸、衣料、脚步或雨声;不要配乐和字幕
很难检查
拍一段很有张力的豪门决裂短剧,要有电影感,4K 超高清,情绪拉满,女主角很美。
可以检查
身份、地点、动作、镜头、声音五栏都填了。生成后你知道该看脸、看手、看那个握腕动作有没有准确发生。
两位虚构都市角色在黄昏暖色窗光下并肩坐着。黑短发女主角说出迟到的歉意,深灰西装男主角认真听完,轻轻握住她的手腕。35mm 镜头固定轴线停留在面部微表情与手部动作,衣着完整,只有房间底噪和自然呼吸声。以眼神、距离和留白推进对手戏张力,保持单一动作与 8 秒连续镜头,无配乐无字幕。
生成之后怎么看
不要只看第一帧。本站落盘过的角色参考样本里,金裙身份总体稳定,但脸型和姿态仍有轻微漂移——这是可核验事实,不是「一致性已解决」。你自己的成片也按这个标准看。
- 从第 1 帧拖到最后一帧,脸有没有换成另一张
- 手、手指、肩颈连接处有没有变形或消失
- 你写的动作是否可见;如果只剩两人静止对望,说明动词还不够具体
- 服装和房间是否还是开场那一套
- 时长、画幅是否接近你的请求(请求值不等于文件实测值)
- 失败就缩短动作、改成图生,或先出一张静帧再动画——不要加更长的小说
选对入口,再进片场
五种模式不是五种滤镜,是五种输入。用错入口,检查清单会失效。需要同一张脸跨镜头时,先读角色一致;已有满意首帧走图生视频;多镜头故事走AI 分镜,但每一镜仍要能单独检查。工具怎么选见横评指南;Sora API 下线后的迁移见替代方案。
- 只有一句话、还没有图:文生视频,先 6–8 秒
- 已有一张构图满意的首帧:图生视频,提示只写运动
- 要同一张脸、同一身衣服:角色参考,先 4 秒、一张参考图
- 已有成片,只想改光或色:改视频,并写清不能改什么
- 多镜头故事:分镜逐条生成再拼接;拼接不会自动修脸或补转场
创作边界写在提示前面
日课默认使用原创虚构角色或已获合法授权的素材。严禁任何涉及未成年人的描写,也严禁未经授权使用真实人物肖像进行合成。
清晰的角色与素材边界能让创作流程长期稳定复现,避免成片因授权或合规问题无法进入下游剪辑与发行。
下一课
第 1 课解决「拍什么」。第 2 课 写同一张脸如何少漂一点:参考图怎么挑、提示里哪些词必须重复、为什么 4 秒比 15 秒更容易检查。
先把上面这一场拍完、看完。没有一场能检查的戏,谈完整短剧没有意义。
FAQ
常见问题
为什么不直接在一个输入框里写完整集短剧?
当前视频生成流程按短镜头运作。一整集需要多镜切换、同脸、同服装和可衔接的声音,模型不会在单次请求里替你完成。先拍好能检查的一镜,再用分镜拼接。
写了很多情绪词,为什么出来只是两个人站着不动?
常见原因是缺少具体肢体动词,或单镜塞了太多节拍。把动作写到具体部位与方向(如「轻轻握住手腕」「转头看向镜头」),并缩短到 6–8 秒。
文生视频一定能保持跨镜头同一张脸吗?
不能保证。文生视频没有视觉身份锚点。需要跨镜头锁脸时请使用角色参考(r2v),并接受短镜内仍可能有轻微漂移。
可以使用真人演员照片作为参考吗?
仅当你拥有该演员肖像的明确合法授权。默认建议使用原创虚构角色设定图,严禁未成年相关内容与未授权真人合成。
日课按什么顺序读最有效?
第 1 课定单镜验收标准,第 2 课锁单人身份,第 3 课拍双人走位,第 4 课做跨语种世界观改编,第 5 至 7 课深入短剧张力、运镜与多集连续工作流。
免登录试排 · 运镜与提示词组装器
选定短剧场景原型与运镜,直接带进片场开拍
不用从零写提示词。先选一个短剧场景原型,再叠加一条单镜头运镜指令,一键带配置打开对应片场模式。
1. 选择场景原型(自动匹配片场模式)
2. 选择镜头运动(单镜只留一种运动)
观看已上线的 AI 短剧与漫剧成片
点击「打开片场」将自动填入对应模式与完整分镜提示词。